 دانشچی پورتال جامع تحقیق و مقاله، مطالب علمی و هنری ، وبگردی و…
وقتی هوش مصنوعی همه چیز را یاد بگیرد
این روزها بحث بر سر محدودیتهای یادگیری ماشین داغ است و بسیاری میخواهند بدانند وقتی هوش مصنوعی تمامی اطلاعات را یاد بگیرد چه اتفاقی می افتد و آیا توسعه این فناوری متوقف خواهد شد؟ واقعیت این است که بحران فعلی تمام شدن اطلاعات خام نیست، بلکه پایان یافتن دادههای معتبر، اصیل و تولیدشده توسط انسان است که زنگ خطر کمبود داده برای آموزش AI را به صدا درآورده است. در ادامه بررسی میکنیم که چرا هوش مصنوعی برای بقا باید از متنهای اینترنتی عبور کرده و معماری یادگیری خود را دگرگون کند.
آیا منابع متنی اینترنت رو به پایان است؟
بله، منابع دادههای متنی باکیفیت و انسانی در اینترنت با سرعت بالایی رو به اتمام است و کمبود داده برای آموزش AI یک چالش واقعی و نزدیک محسوب میشود. حجم دادهها در وب بینهایت به نظر میرسد، اما سهم محتوای ارزشمند و قابلاتکا برای آموزش مدل های هوش مصنوعی بهشدت محدود است. به همین دلیل، آینده هوش مصنوعی دقیقاً به همین دادههای پالایششده بستگی دارد. داده اموزشی هوش مصنوعی باید فاقد نویز، دقیق و بر پایه منطق انسانی باشد.
برای درک بهتر این موضوع، باید بدانید که مدیریت و پیشپردازش این حجم باورنکردنی از دادههای آموزشی اینترنت، نیازمند زیرساختهای پردازشی پایدار و مقیاسپذیر است. دقیقاً به همین دلیل، تأمین بهترین سرور ابری و دسترسی به منابع محاسباتی با تاخیر کم، پیشنیاز حیاتی هر تیم فنی در جریان آموزش و پایدارسازی مدلهای مدرن به شمار میآید.
برای روشنتر شدن تفاوت میان حجم دادهها و کیفیت آنها، جدول زیر مقایسه دقیقی را ارائه میدهد:
| معیار مقایسه | حجم خام داده در وب | داده باکیفیت و پالایششده آموزشی |
| حجم در دسترس | صدها زتابایت (Zettabyte) | محدود به چند تریلیون توکن متنی |
| میزان اعتبار | حاوی اطلاعات غلط، محتوای زرد و تکراری | دارای ساختار منطقی، علمی و اثباتشده |
| سرعت تولید | بسیار بالا (توسط رباتها و انسانها) | کند و نیازمند تخصص مستقیم انسانی |
پدیده «دیوار داده» (Data Wall) و اتمام متون باکیفیت انسانی
اصطلاح «دیوار داده (Data Wall)» دقیقاً به نقطهای اشاره دارد که در آن، سرعت مصرف داده توسط مدلهای بزرگ زبانی از سرعت تولید متن باکیفیت توسط انسانها پیشی میگیرد. براساس برآوردهای پژوهشکده Epoch AI، ذخایر متنهای باکیفیت و عمومی انسانی تا پایان این دهه میلادی به خط پایان نزدیک میشود. بنابراین اگر میپرسید ایا داده برای آموزش AI تمام می شود، پاسخ مثبت است و ما بهزودی با دیوار داده برخورد خواهیم کرد.
چرا نمیتوان از تمام صفحات وب برای آموزش ماشین استفاده کرد؟
هر متنی نمیتواند بهعنوان داده مورد نیاز هوش مصنوعی استفاده شود. دلایل اصلی که مانع استفاده از کل صفحات وب برای آموزش ماشین میشوند، شامل موارد زیر است:
- محتوای تکراری و بیارزش (Spam): بخش عظیمی از اینترنت صرفاً کپیکاری مطالب دیگران است که داده اموزشی هوش مصنوعی را مسموم و گمراهکننده میکند.
- آلودگی به محتوای ماشینی: ورود انبوه متون تولیدشده توسط الگوریتمها به فضای وب، دیتابیسها را کدر کرده و آموزش مدل های هوش مصنوعی را بهشدت مختل میسازد.
- چالش منشأ و کپیرایت: مسئله «منشا و اصالت داده (Data Provenance)» باعث شده تا رسانهها و ناشران بزرگ، دسترسی خزندههای اطلاعاتی را مسدود کنند که این کار حجم منابع در دسترس را کاهش میدهد.
اگر هوش مصنوعی تمام اطلاعات موجود را یاد بگیرد، بعد از آن چه چیزی یاد میگیرد؟
پس از مصرف تمام اطلاعات موجود، مدلها بهجای بازخوانی گذشته، یادگیری از محیط پیرامون فیزیکی و منطق تحلیلی را آغاز میکنند. اگر هوش مصنوعی تمام اطلاعات را یاد بگیرد، روند توسعه متوقف نمیشود، بلکه مرز منطقی میان اتفاقات گذشته و آینده پررنگتر خواهد شد. مدلهای فعلی گذشتهنگر هستند و بر اطلاعات ثبتشده استوارند، در حالی که دانش بشر پویا است. وقتی هوش مصنوعی تمامی اطلاعات را یاد بگیرد چه اتفاقی می افتد ؟ در واقع، نوع داده مورد نیاز هوش مصنوعی به کلی تغییر میکند.
تغییر ماهیت یادگیری: حرکت از «بازخوانی اطلاعات» به درک «دانش نوظهور»
تفاوت بین «اطلاعات (Information)» و «دانش (Knowledge)» بسیار ظریف اما کلیدی است. داشتن متن تمام آزمایشهای شیمی تاریخ به این معنا نیست که ماشین، واکنش یک داروی جدید در محیط آزمایشگاهی فردا را به صورت تجربی درک کرده است. آینده آموزش هوش مصنوعی روی کشفیات علمی جدید، آزمایشهای تجربی آینده و تحولات رفتاری جامعه انسانی تمرکز خواهد داشت تا دانش نوظهور را به دست بیاورد.
راهکار دادههای مصنوعی (Synthetic Data)؛ تولید داده بدون دخالت انسان
با کاهش منابع متنی، آزمایشگاهها به سمت «داده مصنوعی (Synthetic Data)» یا همان دادههایی که ماشین برای آموزش ماشین میسازد، حرکت کردهاند. این رویکرد بهویژه در برنامهنویسی و ریاضیات بسیار کاربردی است. با این حال، مقالات پژوهشی کنفرانسهای معتبری مثل NeurIPS نشان میدهند که تولید حجم انبوه از داده مصنوعی بهتنهایی معجزه نمیکند، بلکه «پالایش داده (Data Curation)» و انتخاب نمونههای حاوی استدلال منطقی است که باعث ارتقای الگوریتم میشود.
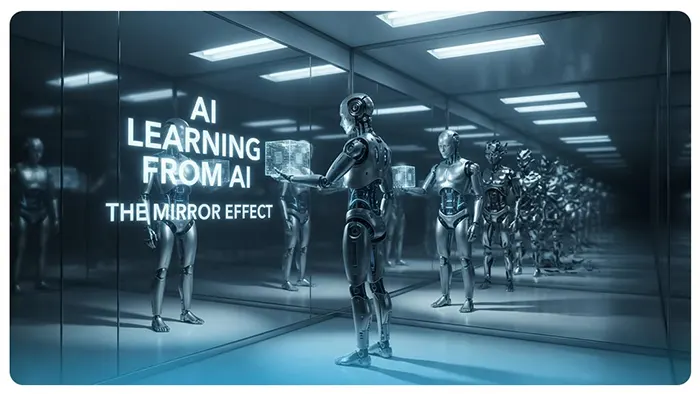
اگر هوش مصنوعی از دادههای خودش یاد بگیرد چه اتفاقی میافتد؟
استفاده مداوم و بدون نظارت از خروجیهای خود ماشین، باعث افت شدید کیفیت، بروز خطاهای منطقی و از بین رفتن تنوع اطلاعاتی در پاسخها میشود. وقتی اینترنت پر از متون تولیدی ماشین شود، مدلهای جدید ناخواسته از خروجی مدلهای قدیمی تغذیه میکنند و یک فاجعه کیفیتی رخ میدهد. هوش مصنوعی بدون داده انسانی معتبر بهسرعت دچار زوال میشود و این مسئله، بحران کمبود داده را تشدید میکند.
پدیده «فروپاشی مدل» (Model Collapse) و اثرات آموزش بازگشتی
فروپاشی مدل یک فرایند تدریجی و مخرب است که در آن، استفاده کورکورانه از محتوای ماشینی باعث از بین رفتن دادههای ظریف و مهم میشود. ژورنال بینالمللی Nature در پژوهشی به این پدیده پرداخته است:
Model collapse is a degenerative process… in which the data they generate end up polluting the training set of the next generation.
ترجمه: «فروپاشی مدل یک فرایند فرسایشی است… که در آن دادههایی که مدلها تولید میکنند، در نهایت باعث آلوده شدن مجموعه آموزشی نسل بعدی میشوند.»
این روند که به آن «آموزش بازگشتی (Recursive Training)» میگویند، مانند کپی کردن متوالی از روی یک برگه فتوکپی است که در هر مرحله ناخواناتر میشود. مسیر این فروپاشی به شکل زیر است:
داده انسانی تنوعدار ← آموزش مدل اول ← متون تولیدی ماشین ← آموزش مدل دوم ← حذف دادههای ظریف ← زوال کامل تنوع مدل
راهکارهای حفظ سلامت مدلهای هوش مصنوعی
داده مصنوعی همیشه مخرب نیست؛ مشکل اصلی ناشی از آموزش بدون غربالگری است. برای حفظ سلامت الگوریتمها و جلوگیری از فروپاشی، راهکارهای زیر بهطور جدی پیگیری میشوند:
- ردیابی منشا دادهها: شناسایی و برچسبگذاری دقیق متون انسانی از متون ماشینی برای حفظ کیفیت ورودیها.
- پالایش هوشمند ورودیها: استفاده از تکنیکهای نوین آماری برای جلوگیری از پذیرش خطاهای مدلهای قبلی.
- تزریق مستمر داده تازه انسانی: نگهداشتن بخشی از ورودیهای واقعی در جریان آموزش تا پویایی سیستم حفظ شود و اتصال آن با واقعیت قطع نگردد.
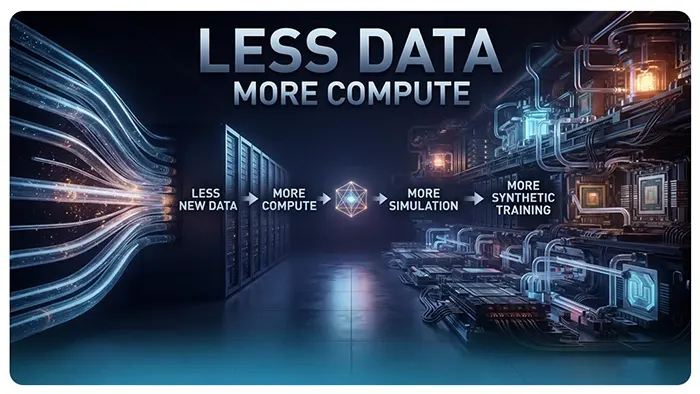
آینده هوش مصنوعی بعد از محدود شدن دادهها چگونه خواهد بود؟
پایان دوران متنهای وب به معنای توقف این فناوری نیست، بلکه زمین بازی را به طور کامل تغییر میدهد. آینده هوش مصنوعی از مقیاسبندی بر پایه «حجم داده خام» عبور کرده و به سمت «کارایی معماری شبکهها و استدلال عمیق» حرکت میکند. وقتی هوش مصنوعی همه چیز را یاد بگیرد، به جای بلعیدن مجدد متون، باید یاد بگیرد که چگونه در دنیای واقعی با مسائل پیچیده روبرو شود.
ورود به دنیای فیزیکی؛ سنسورها، روباتیک و دادههای بلادرنگ
منابع داده جدید قرار است از طریق ارتباط مستقیم ماشین با دنیای فیزیکی تامین شوند. «هوش مصنوعی تجسم یافته (Embodied AI)» با استفاده از سنسورهای اینترنت اشیاء، دوربینها، تجهیزات آزمایشگاهی و رباتها، تجربیات دستاول را جمعآوری میکند. در این مرحله، الگوریتمها یاد میگیرند چطور مثل انسان از تجربه عملی بیاموزند و به متنهای اینترنتی وابسته نباشند.
تغییر تمرکز از «افزایش حجم داده» به «ارتقای استدلال منطقی»
کارایی یک سیستم هوشمند صرفاً به تعداد کلمات خواندهشده بستگی ندارد. همانطور که انسان برای رسیدن به تفکر عمیق نیازی به خواندن تمام کتابهای تاریخ ندارد، نسل بعدی ماشینها نیز با استفاده از یادگیری تقویتی و «عاملهای هوشمند (AI Agents)»، توانایی حل مسئله و استدلال منطقی خود را ارتقا میدهند. در این ساختار، کیفیت استدلال جایگزین کمیت دادهها میشود.
سخن پایانی
وقتی هوش مصنوعی تمامی اطلاعات را یاد بگیرد چه اتفاقی می افتد ؟ اول اینکه مدلها با دیوار دادههای متنی وب روبرو میشوند، اما این به معنی مرگ دانش نیست. دوم، دادههای مصنوعی میتوانند راهکار نجات باشند، اما بدون پالایش دقیق و اصالت انسانی به فروپاشی مدل میانجامند. در نهایت، مرحله بعدی رشد این فناوری وابسته به بلعیدن متون بیشتر نیست، بلکه در گرو یادگیری مستقیم از دنیای فیزیکی، استدلال هوشمند و استفاده از زیرساختهای محاسباتی بهینهتر خواهد بود.